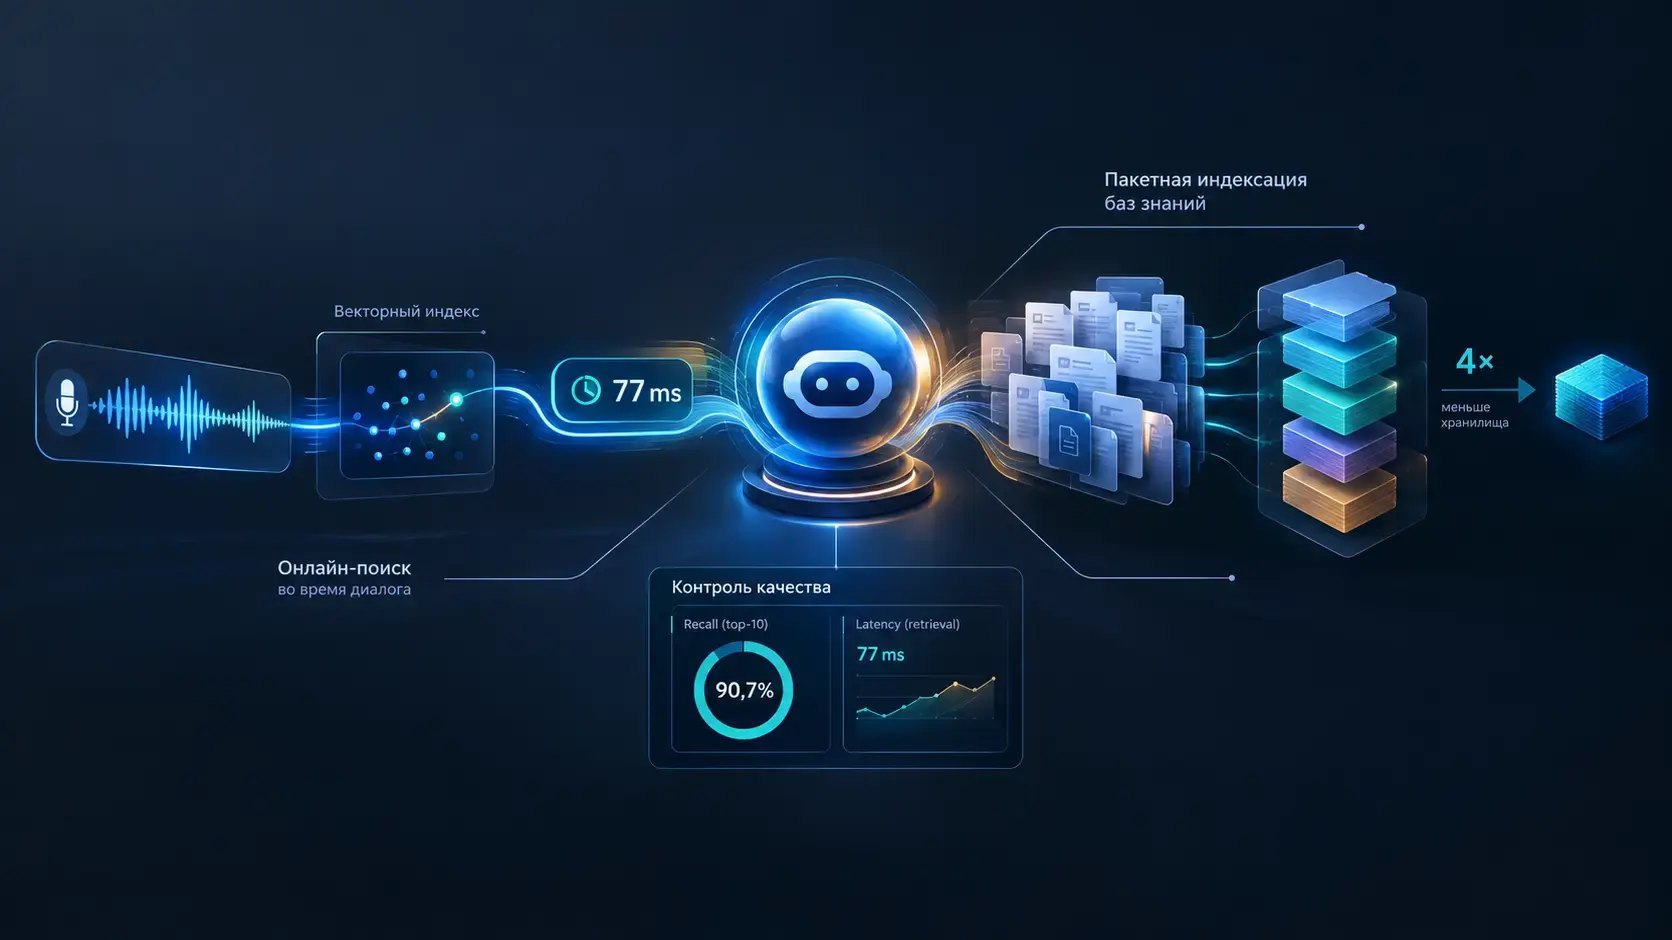
Ada протестировала четыре метода векторного представления на 15 000 запросах и разделила извлечение данных для ИИ-агентов на два контура. Онлайн-поиск на Cohere Embed и Amazon SageMaker AI показал медиану 77 мс и 90,7% полноты поиска в первой десятке результатов. Для пакетной индексации Cohere Model Vault дал заявленные 2,7× больше пропускной способности на доллар, а сжатие уменьшило векторное хранилище в 4 раза.
Контекст и задача
Ada создает ИИ-агентов для клиентского сервиса. Каждый агент должен находить информацию в базе знаний конкретной компании до того, как сформирует ответ. В голосовом канале задержка retrieval особенно заметна: пользователь не видит индикатор загрузки и слышит паузу.
Поэтому команда Ada сформулировала три требования к онлайн-контуру: релевантность найденных материалов, попадание в жесткий бюджет задержки и работа в нескольких регионах при многопользовательской нагрузке. Отдельно существовала пакетная задача — индексировать и переиндексировать тысячи клиентских баз знаний, некоторые из которых содержат десятки тысяч статей.
Исходная гипотеза состояла в том, что одна конфигурация сможет одинаково эффективно обслуживать обе нагрузки. Тест ее опроверг: быстрый поиск в живом диалоге и массовая обработка документов потребовали разных способов развертывания.
Поэтому команда Ada сформулировала три требования к онлайн-контуру: релевантность найденных материалов, попадание в жесткий бюджет задержки и работа в нескольких регионах при многопользовательской нагрузке. Отдельно существовала пакетная задача — индексировать и переиндексировать тысячи клиентских баз знаний, некоторые из которых содержат десятки тысяч статей.
Исходная гипотеза состояла в том, что одна конфигурация сможет одинаково эффективно обслуживать обе нагрузки. Тест ее опроверг: быстрый поиск в живом диалоге и массовая обработка документов потребовали разных способов развертывания.
Решение: два контура вместо одного
Онлайн-поиск для голосового и текстового диалога
Для пути, который выполняется во время пользовательского обращения, Ada самостоятельно развернула Cohere Embed на выделенных инстансах Amazon SageMaker AI. Компания объясняет выбор географической близостью инфраструктуры к своим сервисам и необходимостью контролировать задержку.
В этом контуре Ada заявляет:
Медиана не показывает «хвост» распределения: p95 и p99 не опубликованы. Не указаны модель и версия Embed, тип и число инстансов SageMaker AI, регионы, объем индекса и конкурентный baseline. Поэтому 77 мс нельзя использовать как универсальный SLA или прогноз для другой компании.
В этом контуре Ada заявляет:
- 90,7% полноты поиска в первой десятке результатов — доля запросов, для которых релевантный результат оказался среди первых десяти;
- 77 мс медианной задержки извлечения данных — время только поискового шага, а не полного ответа ИИ-агента.
Медиана не показывает «хвост» распределения: p95 и p99 не опубликованы. Не указаны модель и версия Embed, тип и число инстансов SageMaker AI, регионы, объем индекса и конкурентный baseline. Поэтому 77 мс нельзя использовать как универсальный SLA или прогноз для другой компании.
Офлайн-индексация баз знаний
Для пакетной обработки Ada выбрала Cohere Model Vault — выделенную, управляемую Cohere инфраструктуру. По заявлению участников кейса, она дала примерно 2,7× больше пропускной способности на доллар по сравнению с прежним self-hosted-вариантом Ada и быстрее справлялась с пиками переиндексации.
Абсолютная стоимость, число документов в тесте, период измерения и формула throughput-per-dollar не раскрыты. Показатель описывает эффективность конкретной конфигурации Ada, а не цену Model Vault для любого клиента.
Абсолютная стоимость, число документов в тесте, период измерения и формула throughput-per-dollar не раскрыты. Показатель описывает эффективность конкретной конфигурации Ada, а не цену Model Vault для любого клиента.
Сжатие векторного индекса
Ada также сообщает о четырехкратном сокращении объема векторного хранилища без измеримого ухудшения retrieval благодаря поддерживаемому Cohere сжатию. Компания не публикует исходный объем, формат и степень квантования, порог «измеримого ухудшения» или детализацию качества по сегментам запросов.
Практически это означает, что сжатие следует проверять не только по среднему retrieval-метрику, но и по критическим категориям: редким запросам, длинным документам, нескольким языкам и знаниям, где ошибка дорого обходится.
Практически это означает, что сжатие следует проверять не только по среднему retrieval-метрику, но и по критическим категориям: редким запросам, длинным документам, нескольким языкам и знаниям, где ошибка дорого обходится.
Почему это важно для бизнеса
1. Один RAG-контур может скрывать конфликт целей
Живому диалогу важны задержка и стабильность на хвостах распределения. Пакетной индексации — пропускная способность, цена и скорость обработки всплесков. Попытка оптимизировать обе задачи одной конфигурацией может привести либо к дорогому офлайн-контуру, либо к медленному голосовому агенту.
2. Выбирать нужно систему, а не только модель
На результат влияют размещение относительно приложения, тип вычислительных ресурсов, размер индекса, сжатие, частота обновления базы и сетевой путь. В кейсе одна и та же функциональная категория — embeddings — потребовала self-hosted-развертывания для онлайн-пути и управляемой выделенной инфраструктуры для офлайна.
3. Retrieval-метрика не равна качеству ответа
Top-10 recall проверяет, попал ли релевантный материал в десятку результатов. Она не доказывает, что генеративная модель выбрала правильный фрагмент, корректно его интерпретировала или решила обращение. Нужны сквозные показатели: доля успешных решений, точность по критическим интентам, повторные обращения, передача оператору и оценка клиента.
4. Сжатие стоит включать в экономический тест
Четырехкратное сокращение векторного хранилища выглядит значимо, особенно для множества изолированных баз знаний. Но экономический эффект зависит от реальной цены хранения, вычислений, обновлений и сетевого трафика. Сначала следует проверить качество по собственным запросам, затем считать совокупную стоимость.
Конкурентный и методический контекст
Публичные embedding-бенчмарки полезны только как предварительный фильтр. Например, независимый AIMultiple Embeddings Index использует 200 вопросов из финансов, права, техподдержки и здравоохранения и считает точность ответов. Это другой датасет и другая метрика, поэтому его результаты нельзя напрямую сопоставлять с 90,7% top-10 recall Ada.
Кейс Ada показывает более надежный порядок действий: сначала отбор кандидатов, затем тест на собственных запросах и собственной инфраструктуре, после чего — отдельное решение для каждого профиля нагрузки. Однако опубликованных данных недостаточно, чтобы утверждать, что Cohere Embed будет лучшим вариантом для русского языка, локальных документов или инфраструктуры в России.
Кейс Ada показывает более надежный порядок действий: сначала отбор кандидатов, затем тест на собственных запросах и собственной инфраструктуре, после чего — отдельное решение для каждого профиля нагрузки. Однако опубликованных данных недостаточно, чтобы утверждать, что Cohere Embed будет лучшим вариантом для русского языка, локальных документов или инфраструктуры в России.
Практический шаблон пилота
- Разделите нагрузки. Зафиксируйте онлайн-поиск, пакетную индексацию и переиндексацию как разные сценарии.
- Соберите собственный набор. Возьмите реальные обезличенные запросы, добавьте редкие и критические случаи, определите релевантные документы.
- Сравните минимум три варианта. Держите одинаковыми корпус, фильтры, hardware-класс и правила измерения.
- Измерьте качество. Используйте recall@k или nDCG@k, а также точность ответа и долю успешных решений.
- Измерьте задержку. Смотрите медиану, p95 и p99 отдельно для retrieval и полного ответа.
- Посчитайте экономику. Хранение, вычисления, сеть, переиндексация, сопровождение и стоимость ошибок.
- Проверьте сжатие. Сравните качество в целом и в критических сегментах до и после компрессии.
- Запустите ограниченный трафик. Оставьте возможность отката и ручной эскалации.
Почему это важно
Практическая ценность кейса — не в абсолютных 77 мс или 2,7×, а в отказе от универсальной архитектуры. Для бизнеса это переводит разговор о RAG из выбора «лучшей embedding-модели» в управляемый эксперимент: отдельные KPI для онлайн-обслуживания и пакетной подготовки знаний, собственный датасет, сквозное качество и полная стоимость владения.
«В клиентском сервисе важна не рекордная метрика сама по себе, а устойчивость всей цепочки: поиск, ответ, решение вопроса и понятная эскалация человеку. Разделение онлайн- и офлайн-контуров полезно, если компания заранее измеряет пользовательский эффект и стоимость поддержки двух архитектур».
— Леонид Митин, Руководитель клиентского сервиса Команды, Komanda.ai
Что дальше
Стоит отслеживать, раскроют ли Ada и Cohere версию модели, конфигурацию инфраструктуры, p95/p99 задержки и влияние на successful resolution. Для российского бизнеса до пилота потребуется отдельно проверить качество на русском корпусе, варианты размещения, договорные условия обработки данных и доступность оплаты — в публичных источниках по кейсу это не подтверждено.
Источники:
1. Cohere — “Ada finds the right ingredients for faster, more efficient AI agents”, 27 октября 2026 года; точное время не указано — первичный vendor-authored кейс с данными Ada.
2. Ada — Unified Reasoning Engine, 18 февраля 2026 года — контекст продукта и компании; не подтверждает результаты октябрьского теста.
3. Amazon SageMaker AI — официальный контекст платформы развертывания; не подтверждает метрики Ada.
4. AIMultiple Embeddings Index, версия 1.1 от 1 октября 2026 года — независимый сравнительный контекст; методика и метрики не сопоставимы напрямую с тестом Ada.
1. Cohere — “Ada finds the right ingredients for faster, more efficient AI agents”, 27 октября 2026 года; точное время не указано — первичный vendor-authored кейс с данными Ada.
2. Ada — Unified Reasoning Engine, 18 февраля 2026 года — контекст продукта и компании; не подтверждает результаты октябрьского теста.
3. Amazon SageMaker AI — официальный контекст платформы развертывания; не подтверждает метрики Ada.
4. AIMultiple Embeddings Index, версия 1.1 от 1 октября 2026 года — независимый сравнительный контекст; методика и метрики не сопоставимы напрямую с тестом Ada.
Вопросы и ответы
Почему Ada использовала две инфраструктурные конфигурации?
Онлайн-поиск в разговоре требует низкой и стабильной задержки, а пакетная индексация — высокой пропускной способности и экономичной обработки пиков. В тесте Ada одна конфигурация не оказалась оптимальной для обеих нагрузок.
Доказывают ли 90,7% top-10 recall высокую точность ответов ИИ-агента?
Нет. Метрика показывает попадание релевантного материала в первые десять результатов, но не доказывает корректность финального ответа или успешное решение обращения.
Можно ли ожидать 77 мс в другой компании?
Нет. Результат зависит от региона, сети, hardware, версии модели, размера индекса, фильтрации и нагрузки. Ada не раскрыла полную конфигурацию и p95/p99 задержки.
Как повторить подход Ada в пилоте?
Разделить онлайн- и офлайн-сценарии, собрать собственный тестовый корпус, сравнить несколько решений по качеству, p50/p95/p99, полной стоимости и сквозным показателям обслуживания, затем проверить сжатие и откат на ограниченном трафике.